深度介绍
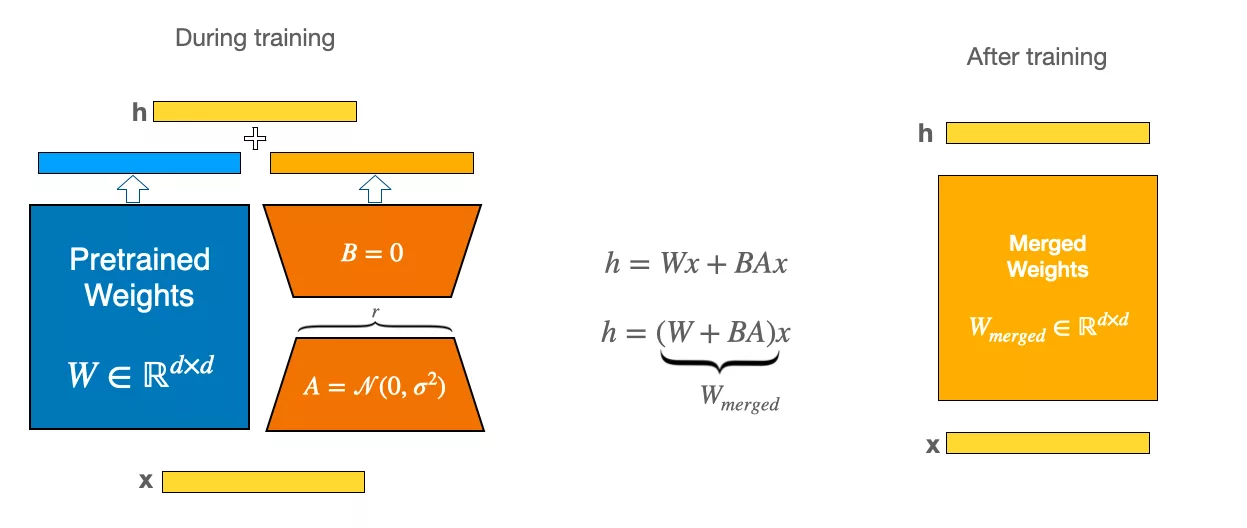
PEFT详细介绍 🎛 一套接口,覆盖三大类适配方法 官方文档把方法分成三类:软提示(Prompt tuning、Prefix tuning、P-Tuning、CPT、Cartridges、Llama-Adapter 等)、层级微调(BEFT、LayerNorm Tuning、可训练 token 等)与适配器类(LoRA 及其多种变体,以及 AdaLoRA、IA3、OFT、BOFT、HRA、HiRA、VeRA、LoHa、LoKr、X-LoRA、SHiRA、MiSS、GraLoRA 等数十种)。官方把整个库定位成「模型适配的框架」,既提供现成实现,也允许自己写方法并注入模型。选型建议从 LoRA 起步,确有需要再换更专门的方法。
💾 官方实测:显存与存储省在哪里 官方 README 给出一组可直接对照的数字:微调 3B 参数模型时,全参微调需要约 47GB 显存,换成 LoRA 只需约 14.4GB,LoRA 配合 DeepSpeed 的 CPU 卸载进一步降到约 9.8GB;12B 参数模型全参会直接显存不足,LoRA 约 56GB,配合 CPU 卸载约 22GB;7B 参数模型同样从显存不足变为约 32GB 与约 18GB。检查点体积也从 11GB 降到约 19MB,而示例任务上的准确率与全参微调接近。这组数字是判断「我的卡能不能训」的最直接依据。
🧩 与 Transformers、Diffusers、Accelerate 打通 它不是一个孤立工具:与 Transformers 集成后可以调用 add_adapter、load_adapter 与 set_adapter 在模型上增删与切换适配器(官方提示 Transformers 侧不包含合并适配器这类功能,需要回到 PEFT 完成);与 Diffusers 集成则把同样的思路带到扩散模型上,官方给出的例子是稳定扩散的 LoRA 微调——全参约需 27.5GB 显存,LoRA 降到约 15.5GB,再加梯度检查点约 8.12GB,最终检查点仅约 8.8MB;与 Accelerate 搭配可在多种硬件上做分布式训练与推理。
🧪 与 TRL 配合:在消费级显卡上做对齐 官方明确说明 PEFT 可用于带强化学习组件的训练,例如排序器与策略模型,并给出与 TRL 配合的实践路径:用 PEFT 加工 TRL 完成直接偏好优化,或在 24GB 消费级显卡上微调 20B 级模型做 RLHF。这条组合是当前个人与中小团队做对齐训练的常见方案——基座模型用低比特量化加载,训练只更新适配器,显存占用与检查点体积都大幅下降。需要注意的是量化加载会带来一定精度损失,是否可接受取决于下游任务对数值敏感的程度。
🧮 量化、内存优化与多适配器管理 除了方法本身,官方还围绕显存做了几件事:文档设有量化与内存高效训练章节,支持把量化与适配方法组合(即常见的量化加 LoRA 路线);提供适配器注入、混用多种 PEFT 方法与 torch.compile 的说明;并支持把适配器合并回基座模型——这在部署阶段很关键,合并后可以按普通模型推理,不必再带适配器加载逻辑。多适配器管理则让同一份基座权重服务多个任务或客户,只需切换适配器,存储与加载成本都很低。
🖧 分布式:DeepSpeed 与全分片数据并行 文档单独设有分布式训练章节,覆盖 DeepSpeed 与全分片数据并行(FSDP)两种路径,并强调内存高效训练的做法。对参数量大的模型,这决定了能否多卡甚至多节点训练;对参数量不大的模型,则可以用 CPU 卸载把显存压力转到内存上换取可训练性——官方表格里 12B 模型从约 56GB 显存降到约 22GB 显存、代价是 CPU 内存占用上升,就是这一权衡的实例。实际配置时建议先按官方示例跑通单机多卡,再扩展到多节点。
📚 方法说明与实践示例的组织方式 官方在 Hugging Face 上维护了一个专门的方法组织页面,逐项介绍库中实现的方法,并附上把它们应用到不同下游任务的笔记本文档;文档站则把「方法总览」「概念指南」与「API 参考」分开,便于先理解再调用。另外官方提供一个方法支持情况的查询空间,用来确认某模型是否官方支持某方法——即便没列出,也可以手动把适配器注入到任意模块。做工程选型时,先查支持矩阵再动手,能省掉不少试错。
⚖️ 许可、版本与生态位置 PEFT 由 Hugging Face 维护,以 Apache-2.0 许可开源,核验时仓库约有 2.2 万 star;发布节奏稳定,最新版本记录为 v0.21.0(2026 年 7 月 28 日),此前有 v0.19.1(2026 年 4 月)与 0.18.1(2025 年 11 月)等。它的定位是「方法参考实现 + 通用适配框架」:既可以直接使用,也可以作为自己实现新方法的底座;代价是与 Transformers、Accelerate、TRL 等生态组件版本耦合较紧,升级时建议整体同步,并先在小任务上验证适配器加载是否正常。
产品特点
核心功能与独有价值 01 方法覆盖面在同类库里最广 官方把方法分为软提示、层级微调与适配器三大类,涵盖 Prompt/Prefix/P-Tuning 等提示方法,以及 LoRA 及 AdaLoRA、IA3、OFT、BOFT、HRA、VeRA、LoHa、LoKr、X-LoRA 等数十种适配器方法。
02 官方给出可直接对照的显存与存储数字 3B 模型从全参约 47GB 降到 LoRA 约 14.4GB、配合 CPU 卸载约 9.8GB;12B 模型从显存不足变为约 56GB 与约 22GB;检查点从 11GB 降到约 19MB,示例任务准确率仍接近全参微调。
03 与 Transformers、Diffusers、Accelerate 深度集成 在 Transformers 上用 add_adapter/load_adapter/set_adapter 管理适配器,在 Diffusers 上把同样思路用于扩散模型(官方示例的稳定扩散 LoRA 检查点仅约 8.8MB),分布式训练交给 Accelerate。
04 适配器可合并、可多套并存 支持把训练好的适配器合并回基座模型以便按普通模型部署,也支持在同一基座上挂载多套适配器按需切换,从而用一份权重服务多个任务或客户。
最近动态
重要更新 2026-07 v0.21.0:当前文档对应的版本 发布记录显示 v0.21.0 于 2026 年 7 月 28 日发布,也是官网文档列出的最新稳定版本(文档站同时提供 main 与 v0.21.0 至 v0.6.2 的历史版本切换)。升级前建议先阅读对应版本的发布说明。
2026-04 v0.19.1:春季版本节点 v0.19.1 于 2026 年 4 月 14 日发布,此前 2025 年 11 月为 0.18.1、2025 年 8 月有 0.18.0 的候选版本。项目保持每年若干次功能版本的节奏,方法实现随新论文持续补充。
2025-07 0.17.0:新增 SHiRA、MiSS 与 MoE 的 LoRA 发布记录中 0.17.0 的标题标注了 SHiRA、MiSS 与面向混合专家模型的 LoRA 支持。这类补充反映了该库对新适配方法的跟进方式:先在文档的方法分类里给出概念说明,再提供可直接调用的实现。
2023-11 长期定位:模型适配的框架与参考实现 官方在 README 中把它定义为「模型适配的框架」——既支持修改权重、包装层、操作 KV 缓存等各类适配思路,也充当多种微调方法的参考实现。这一定位解释了为什么方法列表能持续扩张到上百种,而不必改变调用方式。
产品总结 PEFT(Parameter-Efficient Fine-Tuning)是 Hugging Face 维护的参数高效微调库,官方定位为「参数高效微调的先进方法库」,核心思路是不训练模型的全部参数,只更新少量新增参数就让大模型适配下游任务,从而显著降低算力与存储开销,同时保持接近全参微调的效果。项目以 Apache-2.0 许可开源,核验时 GitHub 仓库约有 2.2 万 star,最新版本记录为 v0.21.0(2026 年 7 月 28 日),文档站提供从 v0.21.0 到 v0.6.2 的历史版本切换。 方法覆盖是它最突出的地方。官方文档把方法分为三类:软提示类(Prompt tuning、Prefix tuning、P-Tuning、CPT、Cartridges、Llama-Adapter 等)、层级微调类(BEFT、LayerNorm Tuning、可训练 token 等)与适配器类(LoRA 及其多种变体,以及 AdaLoRA、IA3、OFT、BOFT、HRA、HiRA、VeRA、LoHa、LoKr、X-LoRA、SHiRA、MiSS、GraLoRA 等)。官方既把这些实现当作可直接调用的工具,也把整个库定位成「模型适配的框架」,允许按同样的接口注入自定义方法。 收益方面官方给出了可直接对照的数字:微调 3B 参数模型时全参约需 47GB 显存,LoRA 约 14.4GB,配合 DeepSpeed 的 CPU 卸载约 9.8GB;12B 模型全参会显存不足,LoRA 约 56GB、卸载后约 22GB;检查点体积从 11GB 降到约 19MB,而示例任务准确率与全参微调接近。集成层面,它与 Transformers(add_adapter、load_adapter、set_adapter)、Diffusers(扩散模型适配器管理,官方示例的稳定扩散 LoRA 检查点仅约 8.8MB)与 Accelerate(分布式训练与推理)打通,并可配合 TRL 做直接偏好优化或在 24GB 消费级显卡上微调 20B 级模型做 RLHF。 此外,文档还覆盖量化、内存高效训练、适配器注入、混用多种 PEFT 方法、torch.compile、DeepSpeed 与全分片数据并行,以及把适配器合并回基座模型以便按普通模型部署。使用前需要注意:量化加载会带来一定精度损失,是否可接受取决于任务;库与 Transformers、Accelerate、TRL 等生态组件版本耦合较紧,升级时建议整体同步;方法众多容易选择困难,建议从 LoRA 起步、按需再换更专门的方法;判断某模型是否官方支持某方法,先查官方的方法支持矩阵再动手。
产品类型 参数高效微调库
支持平台 Python 库(pip install pef / Transformers 集成(add_adap / Diffusers 集成(扩散模型适配器管理) / Accelerate 分布式训练与推理 / TRL 配合做偏好优化与强化学习 / DeepSpeed 与全分片数据并行 / 量化(QLoRA、8 位等) / torch.compile 与模型合并
资费模式 Apache-2.0 许可免费开源;成本来自自备或租用的 GPU 算力。 用户体验调查 PEFT介绍页面对您是否有帮助?
很有帮助 👍 一般 😊 需要改进 👎